
KI im Unternehmen: 3 Wege, wie man LLMs heute einsetzen kann
Update zum 13.11.2026: Was sich seit Mai geändert hat
Der Artikel unten zeigt den Stand vom 23.05.2026. Seitdem hat sich einiges bewegt:
- Frontier-Modelle: Alle drei US-Anbieter haben eine neue Generation veröffentlicht. OpenAI ist über GPT-5.6 bei der GPT-6-Familie angekommen (seit September), Anthropic bei der Claude-5-Familie (Opus 5.5 seit dem 22. September), Google hat im Herbst Gemini 4 vorgestellt.
- Open-Source-Modelle: Auch hier gibt es Nachfolger, etwa Qwen 3.8 (August) und DeepSeek V4 (allgemein verfügbar seit August). Der Abstand zu den Frontier-Modellen bleibt.
- IONOS AI Model Hub: Die Llama-3.1-Modelle und Mistral Nemo wurden im September und Oktober abgeschaltet, neu dabei sind Qwen 3.5 (Juli) und Qwen 3.8 (August). Seit August läuft ein zusätzliches Rechenzentrum in Frankfurt.
- Aleph Alpha: Der Zusammenschluss mit Cohere ist seit dem 16. September vertraglich fixiert. Die Freigabe der Behörden steht noch aus, das gemeinsame Unternehmen soll unter dem Namen Cohere auftreten.
- EU AI Act: Der „Digital Omnibus“ ist seit dem 27. Juli in Kraft. Die Pflichten für Hochrisiko-Systeme greifen damit erst ab dem 2. Dezember 2027 (eigenständige Systeme) bzw. dem 2. August 2028 (KI in regulierten Produkten).
- Kosten: Hetzner hat die Preise für GPU-Server angehoben. Ein GEX44 liegt bei rund 232 €, ein GEX131 bei rund 1.200 € pro Monat aufwärts.
Was bleibt: Die drei Wege und unsere Empfehlung gelten unverändert. Modellnamen altern in Monaten, die Architekturfrage nicht.
Wenn wir mit Kunden über KI im Unternehmen sprechen, läuft die Diskussion fast immer auf dieselben drei Fragen hinaus: Welches Modell ist gut genug für unsere Aufgabe? Was passiert mit unseren Daten – landen unsere Angebote, Verträge und Konstruktionsdaten am Ende im Training des nächsten Modells? Und wer betreibt das Ganze eigentlich am Ende? Diese drei Fragen führen zu drei sehr unterschiedlichen Architekturen.
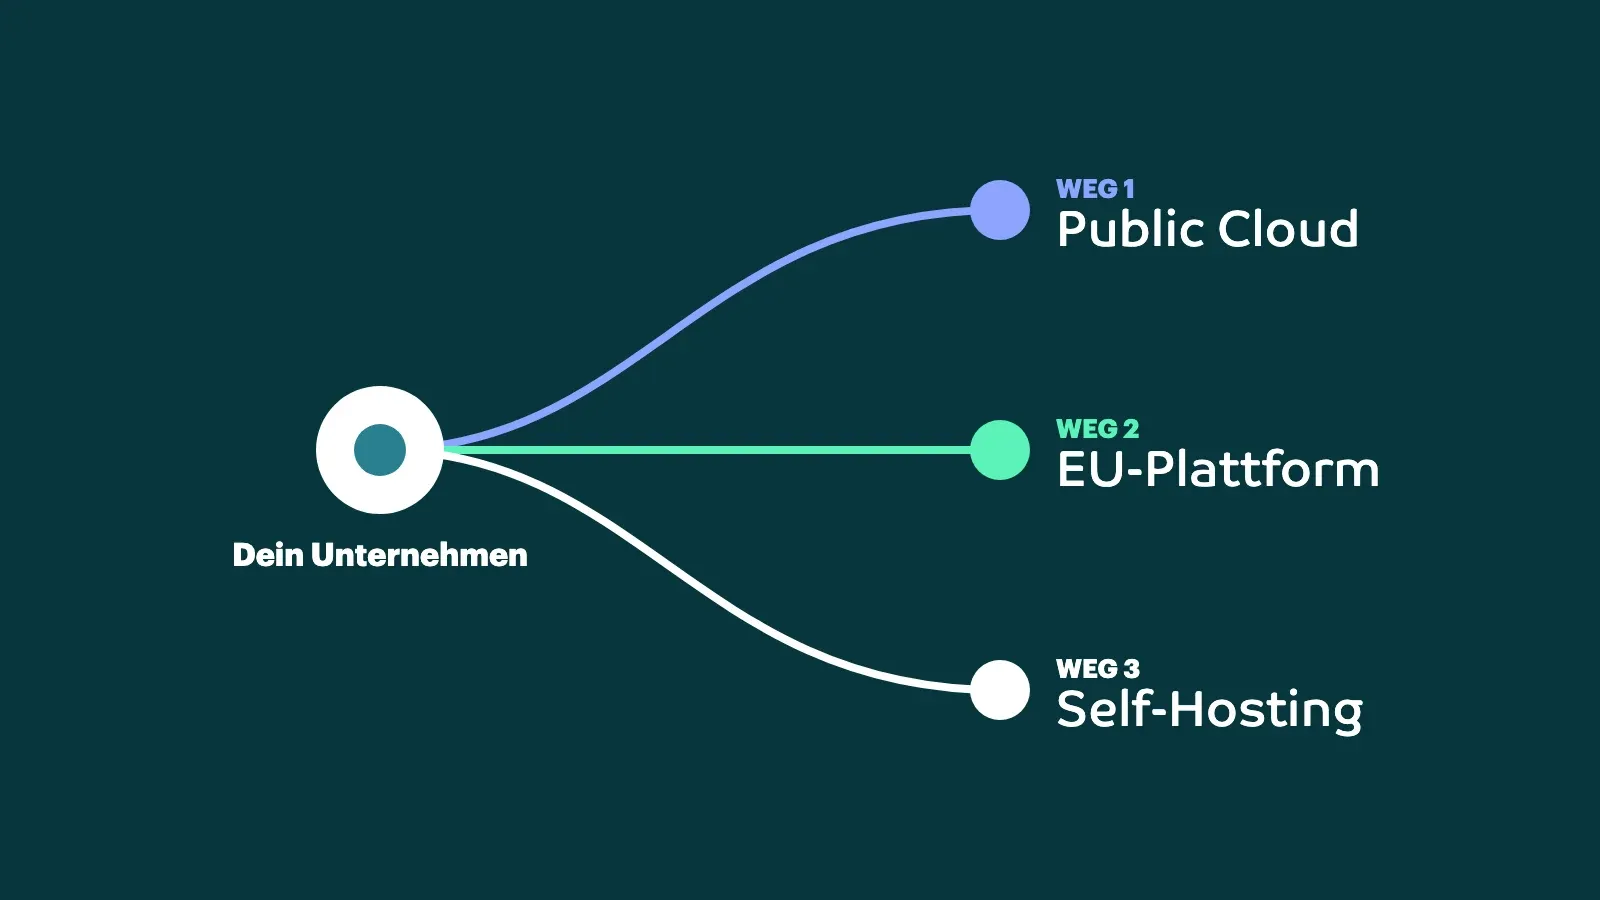
Da ist erstens der direkte Weg zu den großen US-Anbietern: OpenAI, Google, Anthropic. Maximal leistungsfähig, in Minuten angebunden, aber mit Datenschutz-Hausaufgaben. Zweitens der pragmatische Mittelweg über DSGVO-konforme EU-Plattformen wie den IONOS AI Model Hub. Und drittens die vollständig autarke Lösung mit selbst betriebenen Open-Source-Modellen – egal ob auf eigener Hardware oder auf einem dedizierten Cloud-Server. Volle Kontrolle, dafür mit echtem Betriebsaufwand.
Dieser Artikel zeigt, was die drei Optionen wirklich können, wo sie haken und welcher Weg zu welchem Unternehmen passt.
Ein Artikel von Markus Ritter, Software-Architekt bei der SI Code GmbH, erstmalig veröffentlicht am 23.05.2026, aktualisiert am 13.11.2026
Kurzer Rückblick: Wie aus „KI-Spielerei“ Geschäftsrealität wurde
Bevor wir in die Architekturen einsteigen, ein Blick zurück:
- November 2022: OpenAI veröffentlicht ChatGPT auf Basis von GPT-3.5. Generative KI wird massentauglich.
- März 2023: GPT-4 erscheint – die erste Version, die in vielen Aufgaben wirklich produktionsreif ist. Erste Pilotprojekte in deutschen Firmen starten.
- 2024: Open-Source-Modelle (Llama, Mistral, Qwen) holen rasant auf. Selbst-Hosting wird realistisch.
- 2025: Erste Pflichten des EU AI Act werden wirksam. Plattformen wie IONOS AI Model Hub, STACKIT AI und OVHcloud AI Endpoints positionieren sich als DSGVO-konforme Alternative.
- 2026: KI ist in Vertrieb, Marketing, Service, HR und Engineering angekommen – nicht mehr als Pilot, sondern als Werkzeug im Alltag.
Wo KI im Alltag wirklich hilft – und wo (noch) nicht
Bevor wir über Anbieter reden, ein Realitätscheck: Wofür setzt man Large Language Models (LLMs) im Unternehmen ein? Die Antwort ist erstaunlich unspektakulär – und genau das ist der Punkt.
Die produktivsten Einsatzfelder sind selten die spektakulären. Es geht um Textentwürfe für E-Mails und Angebote, das Zusammenfassen von Meeting-Protokollen oder PDFs, die automatische Klassifizierung eingehender Tickets, das Übersetzen von Dokumenten, das Erstellen von Stellenanzeigen aus drei Stichpunkten, Recherche-Assistenz, Code-Reviews, Chatbots für die interne Wissensdatenbank, Datenextraktion aus Rechnungen, Lieferscheinen oder Lebensläufen.
Wer sich morgen früh fragt, welche der eigenen wiederkehrenden Aufgaben eigentlich „Text rein, Text raus“ sind, hat die Liste der KI-Kandidaten schon im Kopf.
Bei einem unserer Kunden – der tts GmbH – haben wir aus genau dieser Logik „Dr. Enable“ entwickelt, einen KI-Berater, der Interessenten durch ein Sales-Gespräch führt und qualifizierte Leads samt PDF-Briefing an HubSpot übergibt. Klingt unspektakulär – spart der Vertriebsmannschaft aber jede Woche viele Stunden.
Die Frage ist jetzt nur: Welches Modell macht das? Und wo läuft es?
Weg 1: Die Bequemen – OpenAI, Google Gemini, Anthropic Claude
Der einfachste Einstieg ist der direkte Weg zu den großen US-Anbietern. Man bucht einen API-Zugang bei OpenAI (GPT-5.5), Google (Gemini 3.1 Pro) oder Anthropic (Claude Opus, Sonnet, Haiku), bekommt einen API-Key und ist in 30 Minuten produktiv. Oder man nimmt die Business-Versionen von ChatGPT, Microsoft Copilot oder Gemini for Workspace und lässt das Team direkt damit arbeiten.
Was dafür spricht
Diese Modelle sind aktuell die leistungsfähigsten am Markt. Reasoning, Code, multimodale Eingaben (Bilder, Audio, Video) – hier spielt die Musik. Die Anbindung ist trivial, die Dokumentation gut, das Ökosystem riesig. Wer schnell ausprobieren will, ob KI im eigenen Prozess überhaupt etwas bringt, ist hier richtig.
Was dagegen spricht
Datenschutz – und das Bauchgefühl beim Thema Betriebsgeheimnisse. Wichtig zur Einordnung: OpenAI (Business/Team/Enterprise und API), Anthropic (Claude API und Enterprise) und Google (Gemini API, Workspace) sagen vertraglich zu, dass Eingaben aus Business-Tarifen nicht zum Training ihrer Modelle verwendet werden. In den Consumer-Versionen (Free-ChatGPT, Gemini Consumer, Claude Free, Pro und Max) sieht das anders aus – dort muss Training aktiv abgewählt werden, sofern es überhaupt möglich ist. Heißt: Wenn Vertriebsmitarbeiter heimlich die kostenlose ChatGPT-App nutzen, um die Konkurrenzanalyse zu schreiben, wandern die Unternehmensdaten möglicherweise direkt ins Training.
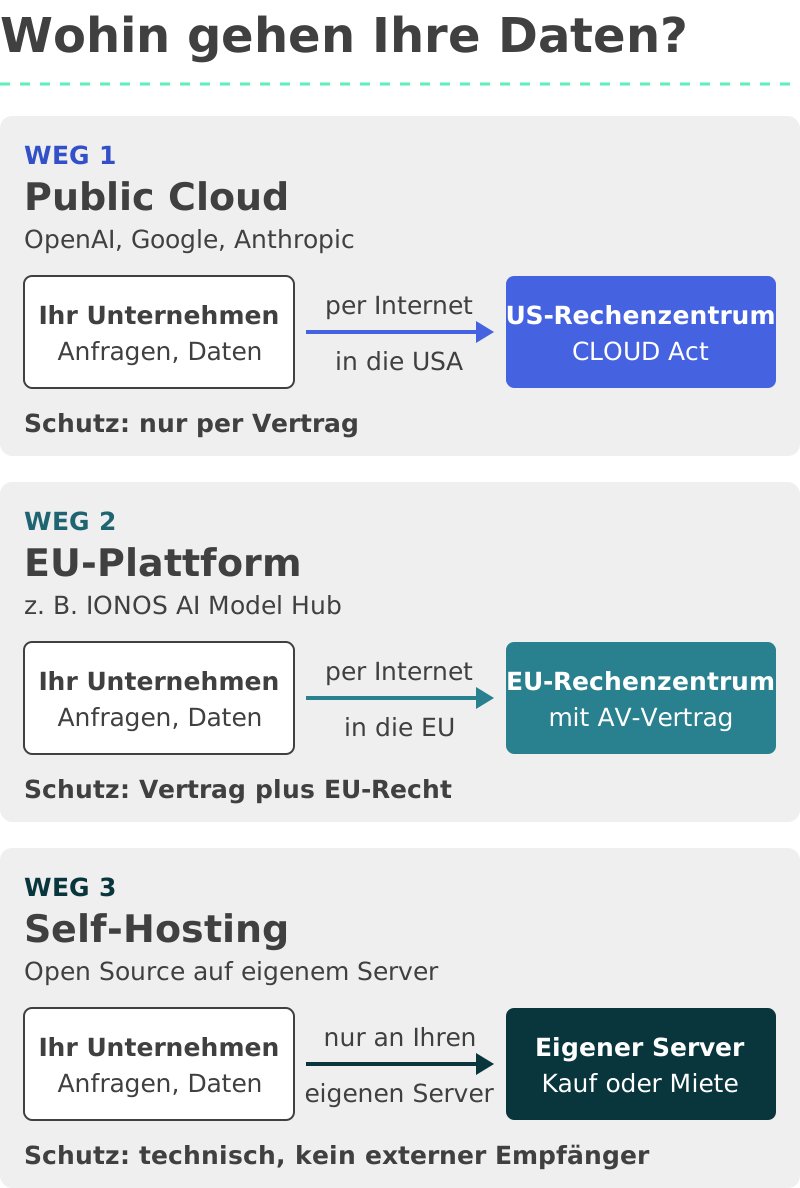
Aber selbst mit korrekt konfiguriertem Business-Tarif bleibt ein Vertrauensproblem: Man verlässt sich auf eine vertragliche Zusage eines US-Unternehmens, das US-Recht unterliegt (Stichwort CLOUD Act). Für Marketing-Texte, generischen Code oder öffentliche Informationen ist das okay. Sobald aber personenbezogene Daten, Konstruktionsunterlagen, Margen, Verträge oder mandatsbezogene Inhalte (Anwalt, Steuerberater, Arzt) ins Spiel kommen, braucht es mindestens einen sauberen Auftragsverarbeitungsvertrag, je nach Risiko eine Datenschutz-Folgenabschätzung, klare interne Richtlinien – und ein paar ruhige Nächte.
Weg 2: Der pragmatische Mittelweg – DSGVO-konform über EU-Anbieter
Hier kommen Plattformen ins Spiel wie der IONOS AI Model Hub, STACKIT AI von der Schwarz-Gruppe, OVHcloud AI Endpoints, PhariaAI von Aleph Alpha (Heidelberg, Zusammenschluss mit Cohere im April 2026 angekündigt) oder die Modelle von Mistral (Paris, mit EU-Hosting-Optionen). Das Prinzip: Man bekommt einen API-Zugang, der sich anfühlt wie OpenAI – nur dass die Server in Deutschland oder der EU stehen, der Anbieter europäischem Recht unterliegt und ein sauberer AV-Vertrag Standardbestandteil ist.
Konkret beim IONOS AI Model Hub heißt das: Dort lassen sich Open-Source-Modelle wie Llama 3.3 (Meta), Mistral Small oder gpt-oss (OpenAI) ansprechen – alles über eine OpenAI-kompatible API, mit Rechenzentren in Deutschland. Die Daten verlassen den EU-Wirtschaftsraum nicht, werden vertraglich nicht für Training verwendet, und es gibt einen Vertragspartner, dem sich im Zweifel eine ganz normale Mahnung schicken lässt. Ein entscheidender struktureller Vorteil: Da hier ohnehin Open-Source-Modelle gehostet werden, hat der Anbieter gar kein eigenes wirtschaftliches Interesse daran, die Eingaben in Training zu stecken – anders als bei den Frontier-Anbietern, die ihr Geschäftsmodell auf immer besser werdenden eigenen Modellen aufbauen.
Was dafür spricht
DSGVO-Konformität ist deutlich einfacher zu erreichen. Die Wege sind kurz (Server in Deutschland statt in Iowa). Die Modellauswahl ist inzwischen erstaunlich gut – Llama 3.3 70B oder Mistral Small sind in vielen Alltagsaufgaben kaum von den US-Spitzenmodellen zu unterscheiden. Und das europäische KI-Ökosystem wird unterstützt, falls das wichtig ist.
Was dagegen spricht
Bei den absoluten Spitzenmodellen (komplexes Reasoning, sehr lange Kontextfenster, multimodale Premium-Features wie Voice-to-Voice) hinken die Open-Source-Modelle den Frontier-Modellen aus den USA noch etwas hinterher. Der Funktionsumfang (etwa Bildgenerierung, Realtime-Audio) ist oft schmaler.
Faustregel: Für die meisten Mittelständler ist das der richtige Dauerzustand. Auch bei DSGVO-konformen Websites mit KI-Funktionen ist das in 9 von 10 Fällen der saubere Weg.
Weg 3: Die Autarken – Open Source in eigener Verantwortung
Der dritte Weg ist der ambitionierteste: Man betreibt den kompletten Modell-Stack selbst. Wo die Hardware steht, ist dabei zweitrangig – wichtig ist, dass das Unternehmen sie kontrolliert. In der Praxis sehen wir drei Varianten: eigene Hardware im Serverraum (eine GPU-Workstation oder ein dedizierter Server), gemietete dedizierte GPU-Server bei deutschen oder europäischen Anbietern (etwa GPU-Server von Hetzner, OVH Bare Metal, IONOS) oder Hyperscaler-Instanzen (AWS, Azure, GCP) mit zugewiesener GPU. Der entscheidende Unterschied zu Weg 2: Es läuft das eigene Modell auf der eigenen Maschine – niemand sonst hat technischen Zugriff auf die Inferenz. Bei US-Hyperscalern gilt allerdings wieder US-Recht, volle Souveränität gibt es nur auf eigener Hardware oder bei europäischen Anbietern. Die Werkzeuge dafür sind erstaunlich ausgereift.
Der Stack in der Praxis
Als Modell-Runtime nimmt man Ollama oder LM Studio für den Einstieg, vLLM oder llama.cpp für die professionelle Variante. Als Modelle stehen die üblichen Verdächtigen bereit: Llama 3.3 (Meta), Mistral Small, Qwen 3.5 (Alibaba), DeepSeek, Gemma 4 (Google) – alles frei verfügbar, viele auch kommerziell nutzbar. Drumherum: OpenWebUI als Chat-Oberfläche für die Mitarbeiter, LangChain oder LlamaIndex für RAG (also das Verheiraten des Modells mit den eigenen Dokumenten), eine Vektordatenbank wie Qdrant oder Chroma. Sauber containerisiert mit Docker und Kubernetes – und damit problemlos zwischen eigener Hardware, Hetzner-GPU-Server und Hyperscaler-Cloud verschiebbar, falls sich die Anforderungen ändern.
Was dafür spricht
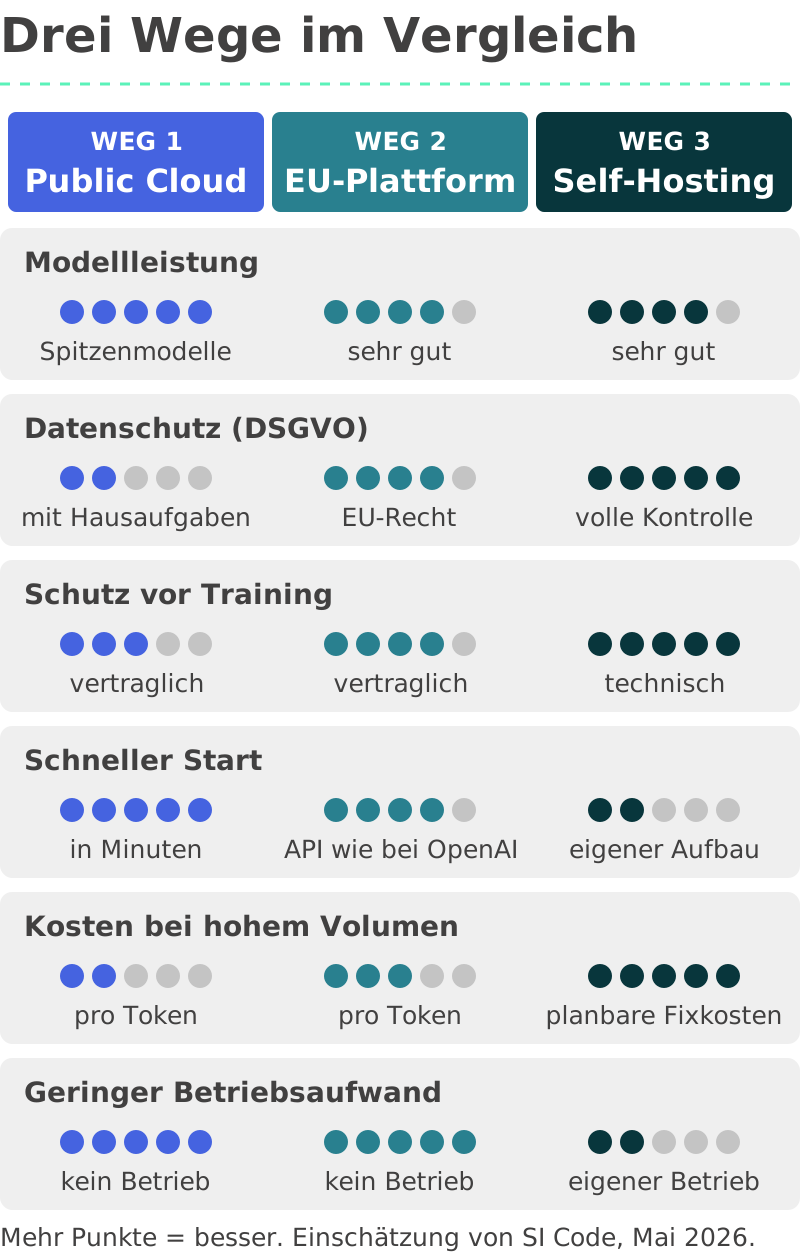
Volle Kontrolle – und zwar nicht nur vertraglich, sondern technisch. Das Unternehmen bestimmt, welches Modell läuft, wo es läuft und wer Zugriff hat. Die Frage „Werden die eigenen Eingaben zum Training fremder Modelle verwendet?“ stellt sich gar nicht erst, weil es schlicht keinen externen Empfänger der Inferenz gibt. Man ist unabhängig von Preiserhöhungen, von API-Änderungen, von politischen Verwerfungen. Modelle lassen sich auf die eigenen Daten finetunen, ohne dass diese Daten jemals ein fremdes Netz sehen.
Die Kostenstruktur ist nach Variante unterschiedlich, aber durchgehend planbar: Eigene Hardware bedeutet eine Anschaffungsinvestition (für ein flüssiges 30–70B-Setup typischerweise 5.000–15.000 €) plus Strom – ein dedizierter GPU-Server bei einem deutschen Cloud-Anbieter liegt aktuell je nach Ausstattung zwischen 200 und 1.500 € pro Monat. Ab einem gewissen Anfragevolumen unterbietet das die Public-Cloud-Token-Kosten deutlich.
Was dagegen spricht
Es braucht jemanden, der das aufsetzt und betreibt. Modelle wollen aktualisiert werden, GPUs wollen gekühlt werden, Skalierung will geplant sein. Und: Selbst die besten frei verfügbaren Open-Source-Modelle erreichen aktuell nicht ganz das Niveau eines GPT-5.5 oder Claude Opus 4.7 – bei einfachen Aufgaben fällt das nie auf, bei komplexen Analysen schon.
Fazit: Welcher Weg passt zu welchem Unternehmen?
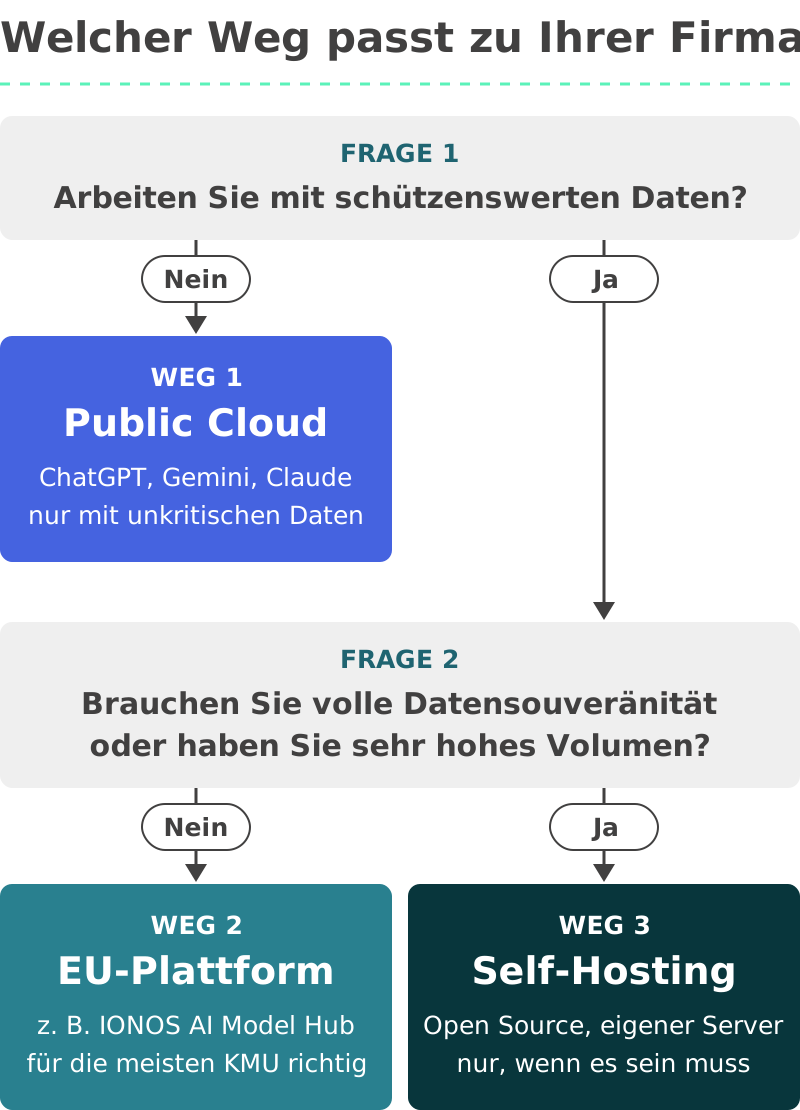
KI 2026 ist kein technisches Problem mehr – es ist eine Architekturfrage. Die Modelle sind da, die Anbieter sind da, die Werkzeuge sind da. Die Frage ist, welche Kombination zum eigenen Unternehmen passt. Aus unseren Projekten lässt sich das überraschend klar zusammenfassen:
- Mit Weg 1 anfangen, um zu verstehen, was KI im eigenen Unternehmen leisten kann – aber ausschließlich mit unkritischen Daten. Marketing-Texte, allgemeine Recherche, Code-Reviews. Niemals Kundendaten, niemals Personalakten.
- Auf Weg 2 wechseln, sobald die ersten echten Use Cases stehen. Sobald klar ist, wofür KI genutzt werden soll, lohnt sich der Aufwand für eine DSGVO-konforme Plattform – und damit fahren 80 % der KMU dauerhaft gut.
- Auf Weg 3 nur gehen, wenn es sein muss. Echte Datensouveränität (Verteidigung, Forschung, hochsensible Branchen) oder hohe Volumen, bei denen API-Kosten ins Gewicht fallen – sonst bleibt Eigenbetrieb teurer und langsamer.
- Nicht vergessen: Das Modell ist nur die halbe Miete. Die andere Hälfte ist die saubere Anbindung an die eigenen Systeme (CRM, ERP, Wissensdatenbank, Website), eine durchdachte UX und ein vernünftiger Prozess für Pflege und Weiterentwicklung. Genau hier liegt der Unterschied zwischen einem KI-Prototyp, der nach drei Monaten in der Schublade verschwindet, und einer Lösung, die jeden Tag Stunden spart.
- Den Erfolg messen, nicht die Technik. Wie viele Minuten spart das Tool pro Vorgang? Wie viele Leads kommen mehr rein? Wie viele Tickets werden automatisch korrekt klassifiziert? Wer das nicht misst, weiß auch nicht, ob sich Aus- oder Rückbau lohnt.
Wenn Sie Unterstützung suchen: Wir bei SI Code haben alle drei Wege in Kundenprojekten umgesetzt – von der schnellen ChatGPT-Integration über DSGVO-konforme LLM-Anbindungen bis zur vollständig autarken On-Premise-Lösung. Sprechen Sie uns an, wir prüfen gemeinsam, welcher Weg zu Ihrem Unternehmen passt.
Über den Autor
Markus Ritter
Software-Architekt